Benchmark WebMCP: Jev escolhe a tool e outro modelo preenche
idan levin · @0xidanlevin233 mil visualizações no X
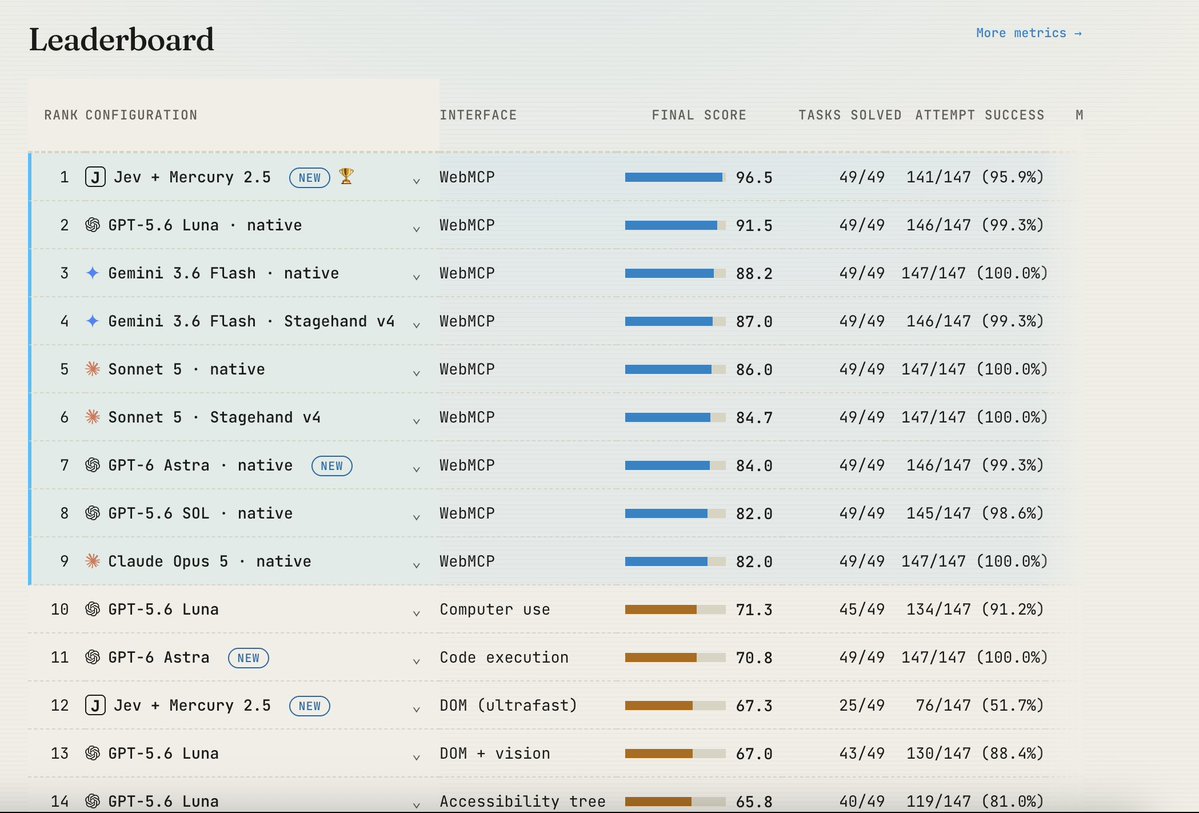
Benchmark de automação web em que o Jev escolhe qual tool WebMCP chamar e um LLM rápido gera os argumentos. A dupla resolveu 100% das tarefas com custo de modelo cerca de 112 vezes menor que uma alternativa com computer use e execução de código. Sem WebMCP, a configuração resolvia 25 de 49 tarefas.
O que o Jev decide aqui?
A cada etapa, o Jev escolhe (Choice) qual tool WebMCP usar, e outro modelo gera os argumentos da chamada.
Qual foi o resultado?
100% das tarefas resolvidas com custo de modelo cerca de 112x menor; sem WebMCP 25/49 tarefas, com WebMCP 49/49.
Por que isso importa?
O resultado combina duas ideias: expor o site como tools estruturadas e separar a escolha da tool da geração dos argumentos. Quando a página oferece ações nomeadas, o modelo não precisa adivinhar pela interface, e a decisão vira uma escolha simples entre opções.
Para quem constrói produtos web, é um argumento para expor ações do app como tools para agents, seja em SaaS, e-commerce ou painéis administrativos. Cuidado: tools com efeito real, como compra ou exclusão, precisam de autenticação e confirmação próprias.
Post original

idan levin
@0xidanlevin
We just ran Jev on our WebMCP benchmark. The result: basically broke the benchmark. Jev + Mercury 2.5 (a fast, low-cost LLM) using WebMCP solved 100% of the tasks at roughly 112× lower model cost than GPT-6 Astra using computer use with code execution. Compared to Astra using